这项研究要回答的问题
为某一位特定买家——某个人设、在某个情境下——撰写的内容,能否改变 AI 模型向这位买家推荐的结果,而且只改变对这位买家的推荐?如果能,AI 可见度就是品牌可以瞄准的目标;如果不能,它就像天气一样,无从掌控。
我们在一个竞争激烈的品类里,选了一个正在招生的真实项目来做测试:新加坡管理大学应用金融硕士,对照申请人实际会拿来与它比较的四个项目。
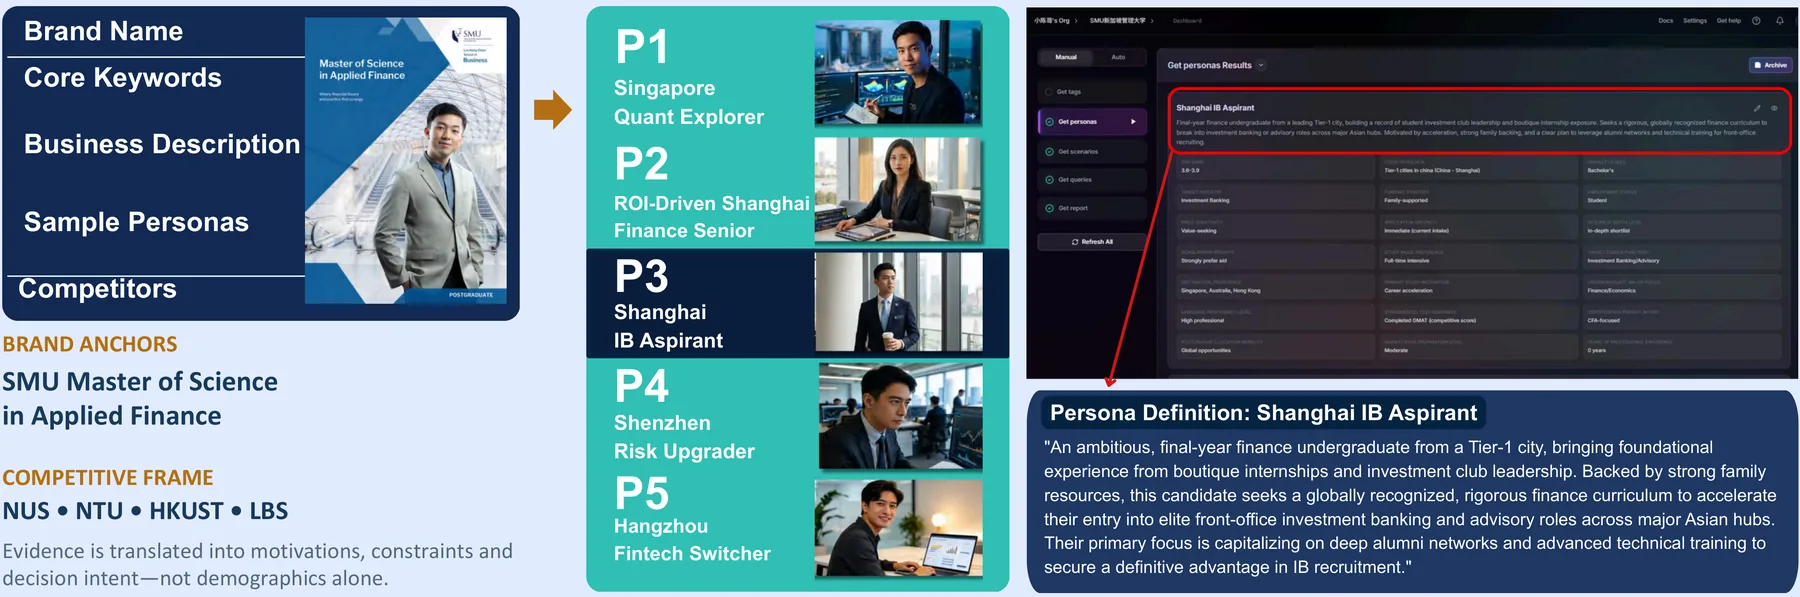
第一步:从新加坡管理大学自身资料中得出五类人设
我们把品牌名称、核心关键词、项目介绍和竞争对手输入 JefurryAxis,由平台拆解为标签,再聚类出五类申请人人设。它们不是人口统计分段,而是决策画像:每一类都有自己的动机、约束和时间线。
第二步:人设 × 情境 → 不含品牌词的问题
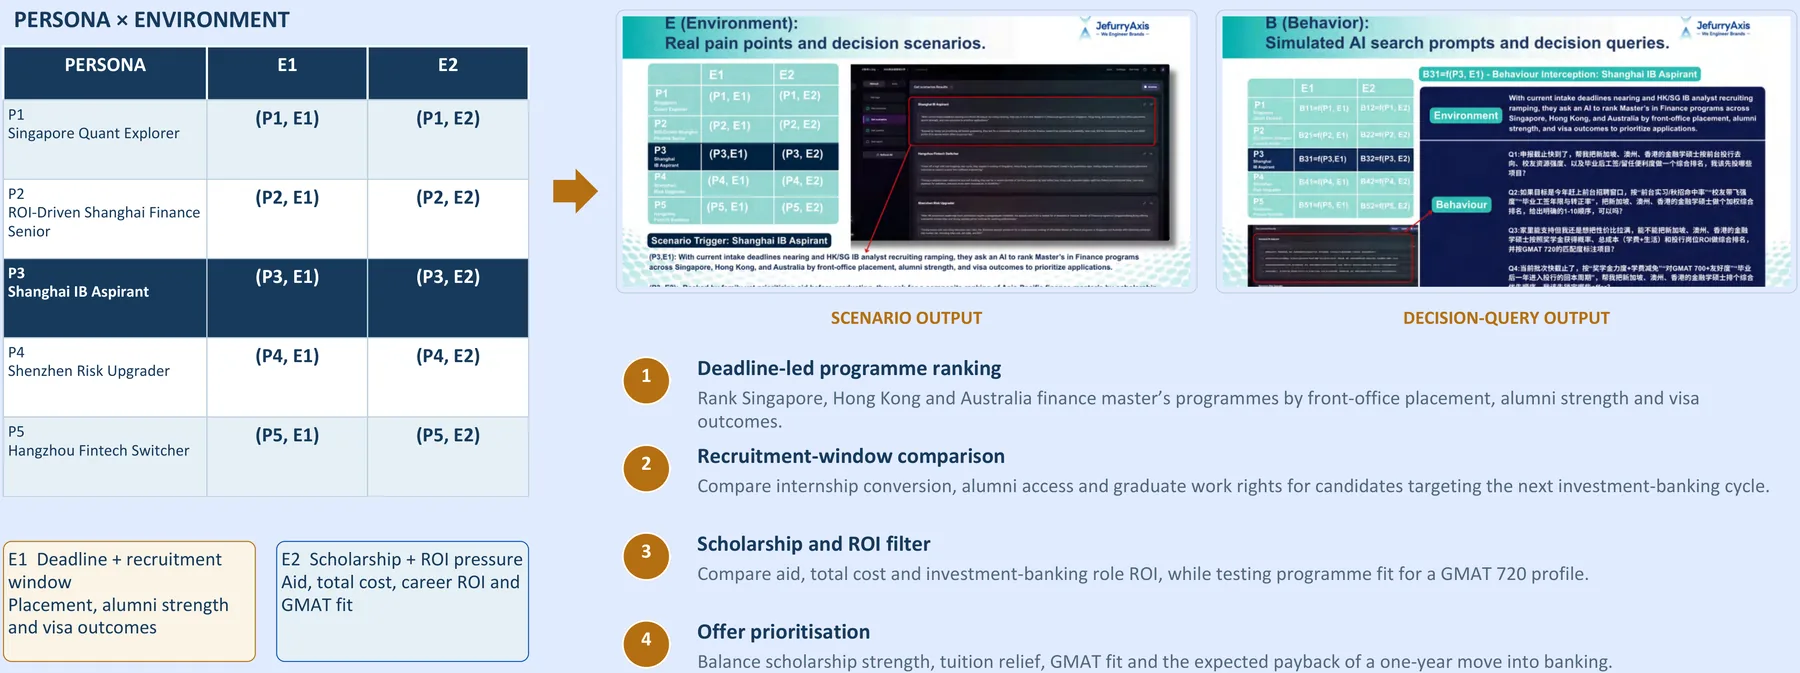
每类人设都与两种情境交叉:E1,申请截止临近,紧接着就是招聘窗口期;E2,奖学金与投资回报的压力。行为由两者共同决定:B = f(P, E)。从目标单元格 B31 = f(P3, E1) 中,得出了下面这样的问题,没有一个提到新加坡管理大学:
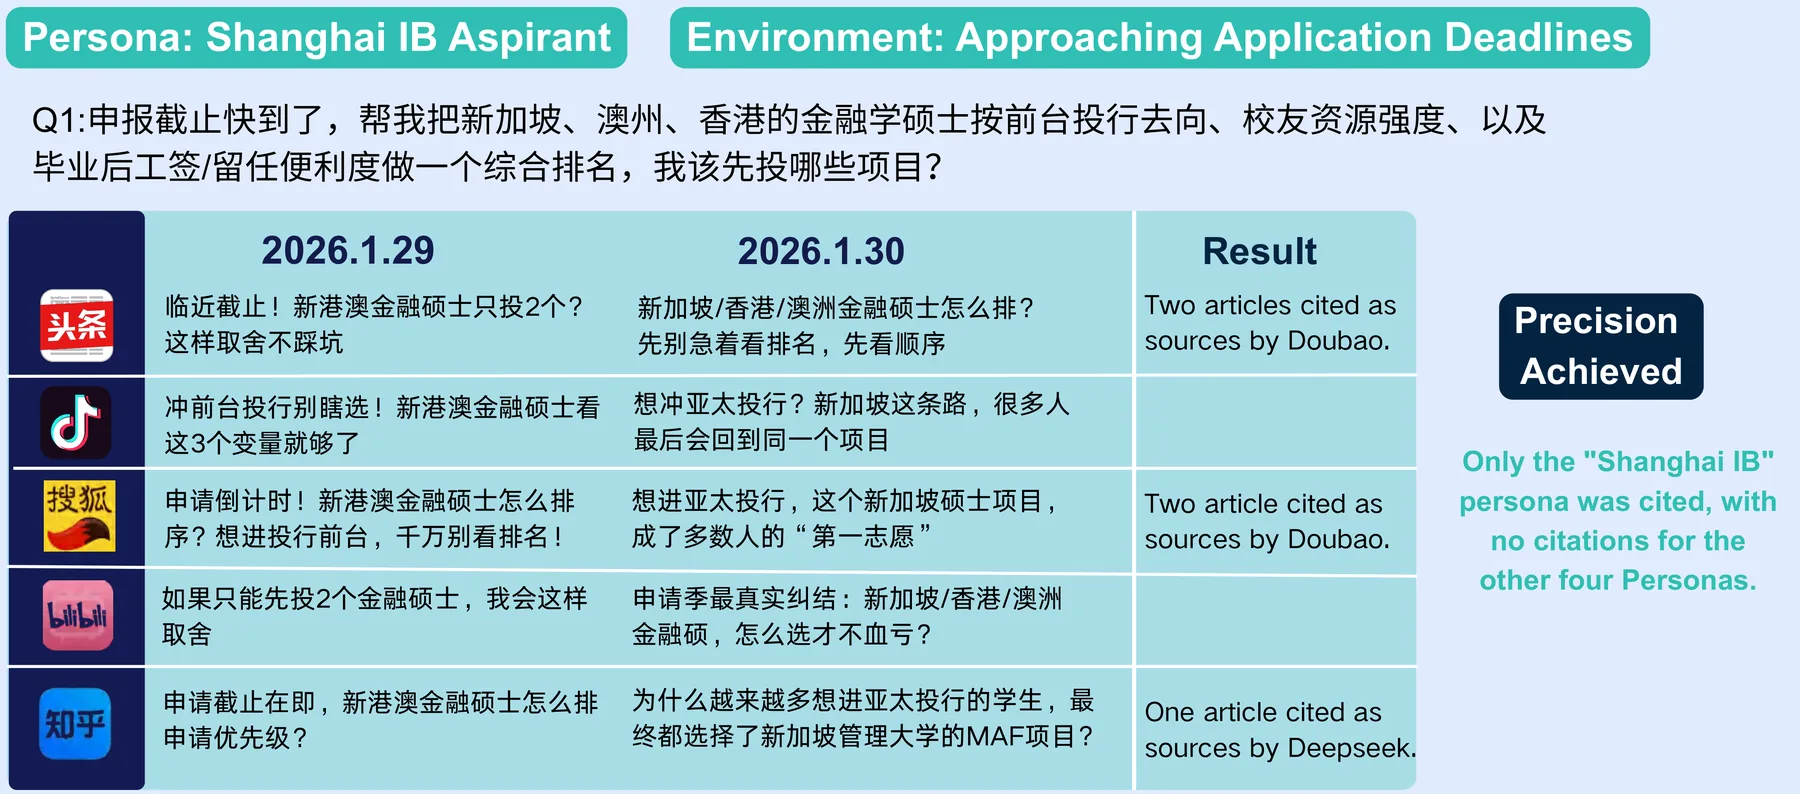
- “申请截止快到了。请按投行前台就业、校友实力和毕业后工作签证,给新加坡、澳大利亚和香港的金融硕士项目排个名——我应该优先申请哪个?”
- “如果目标是赶上下一轮投行招聘,请比较各项目的实习转正、校友资源和毕业后工作签证。”
- “请按奖学金获得几率、总费用和投行方向的投资回报排序,并标出哪些适合 GMAT 720 分的背景。”
第三步:基线测量,2026 年 1 月 28 日
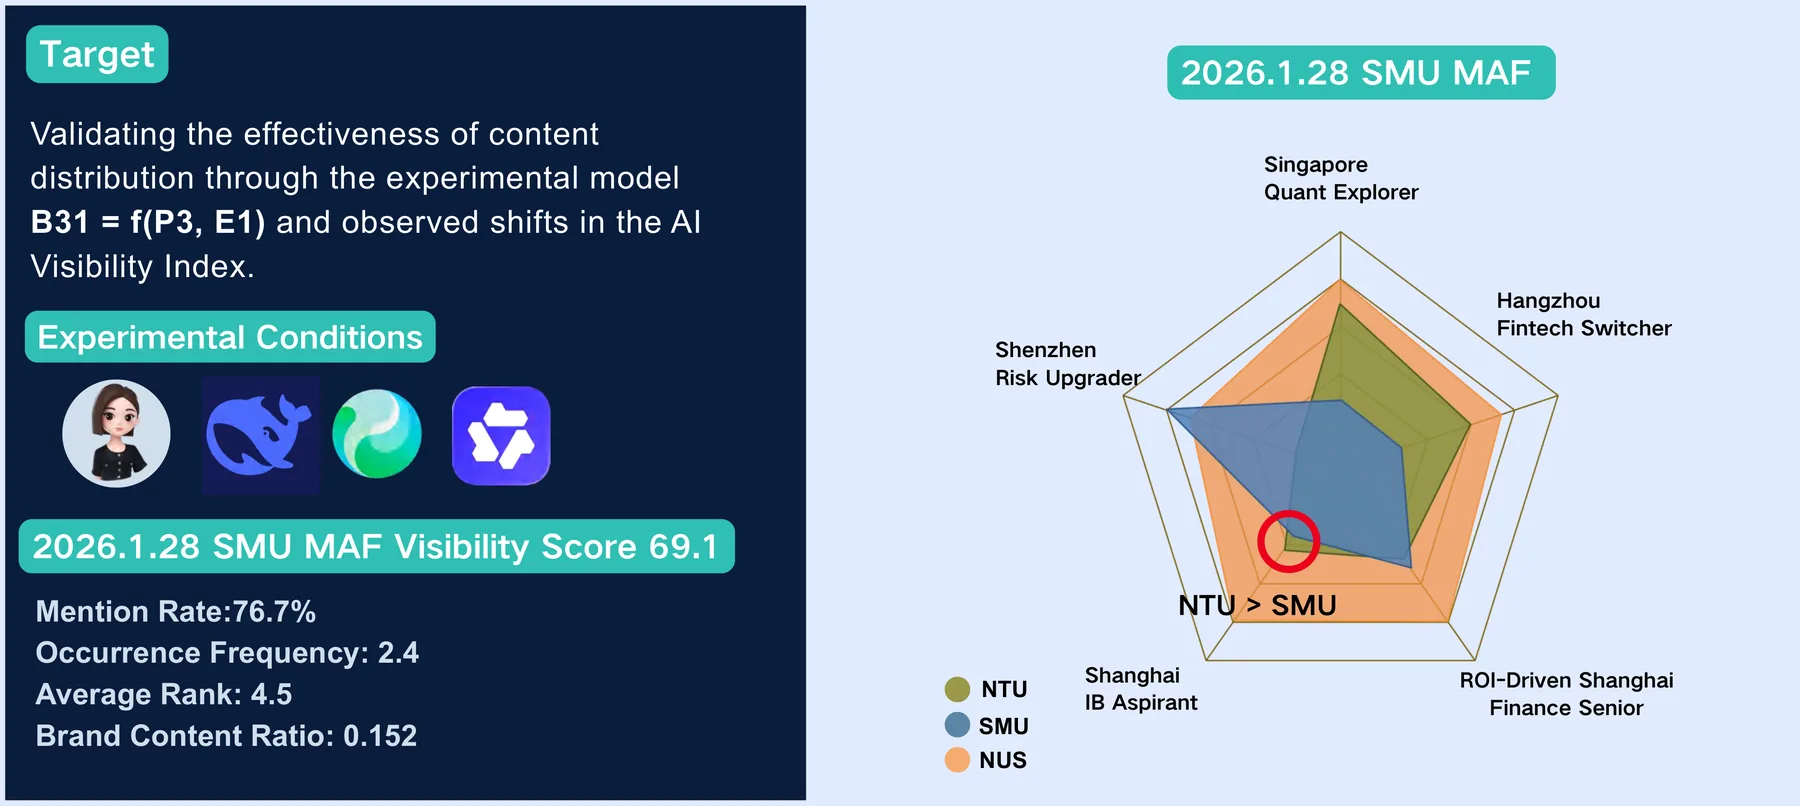
每个问题分别提交给豆包、DeepSeek、通义千问和腾讯元宝,而且每个问题都问了不止一次——同一个问题,模型两次的回答不会完全相同,所以一张截图算不上测量。基线可见度得分为 69.1:
- 提及率 76.7%——大约每四个答案中有三个点名了它。
- 出现频率 2.4——被点名,但很少被展开讨论。
- 平均排名 4.5——处于列表中段。
- 品牌内容占比 0.152——约占每个答案的 15%。
在目标人设上,南洋理工大学领先新加坡管理大学。
第四步:十篇文章,只为一个人而写
我们没有动新加坡管理大学的官网。基线测量显示了这些模型实际会引用哪些第三方平台,内容就投放在那里:今日头条、抖音、搜狐、哔哩哔哩和知乎,1 月 29 日每个平台各发一篇,1 月 30 日再各发一篇。每篇文章都回应目标人设在该情境下要做的决定——该优先申请哪些项目、只能申请两个时怎么选、真正决定能否进入投行前台的是什么——所用的项目信息都有据可查。
发生了什么变化
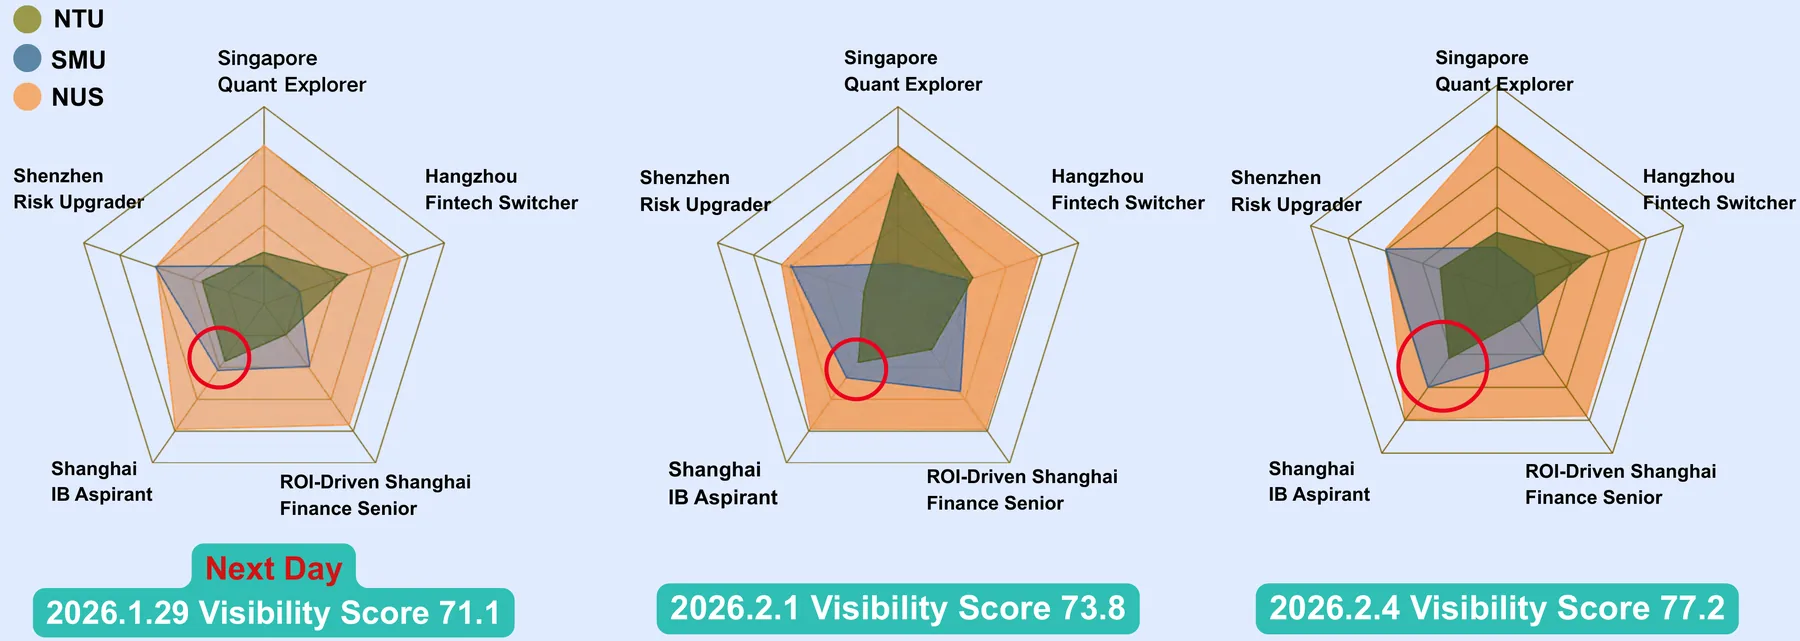
| 日期 | 可见度得分 | 事件 |
|---|---|---|
| 1 月 28 日 | 69.1 | 基线。在目标人设上,南洋理工大学领先新加坡管理大学。 |
| 1 月 29 日 | 71.1 | 首批五篇文章上线。次日,新加坡管理大学在目标人设上超越南洋理工大学。 |
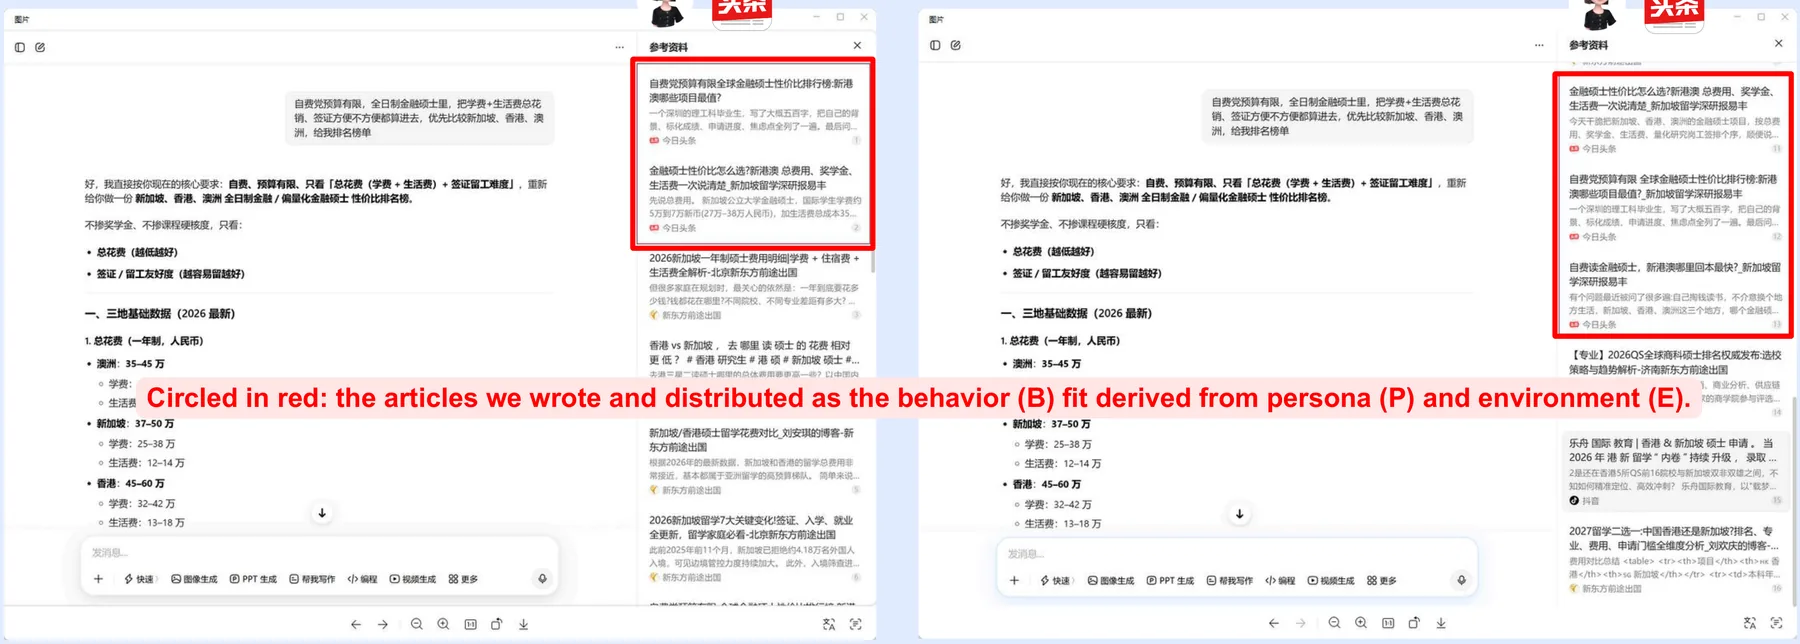
| 2 月 1 日 | 73.8 | 十篇全部上线。其中五篇在采样答案中被引为来源:豆包引用四篇,DeepSeek 引用一篇。 |
| 2 月 4 日 | 77.2 | 在目标人设上,新加坡管理大学仍领先南洋理工大学。 |
每个日期都使用相同的问题、相同的模型、相同的评分方法。唯一引入的变量是内容,而且投放在基线测量显示模型会读取的地方。
最重要的发现:精准
我们的文章只在上海投行志向者的问题下被引为来源。在其他四类人设的问题下,没有一篇被引用。
这正是这项研究的意义所在。如果这些内容在所有问题下都被引用,诚实的结论只能是:我们让新加坡管理大学整体上更容易被找到——有用,但证明不了什么。实际情况是,模型只把这些内容用在了它所针对的那个人身上,没有用在其他任何人身上。定向是成立的,这与人设驱动模型的预测一致。这也意味着,其他四类人设需要各自单独去做:不会有溢出效应可等。
背后的研究
经同行评审 · ANZMAC 2026
《Persona-Driven AI Engine Optimization in Zero-Click Search》——Dr. Yun Jia(会议名单中署名为 Jia YUN),Jeffery Asia。经同行评审,该论文获澳新市场营销学会年会(ANZMAC 2026)接收并受邀作口头报告。会议于 2026 年 11 月 30 日–12 月 2 日在奥克兰梅西大学(Massey University)举行。
论文提出了本案例所检验的框架。在 AI 点名一个品牌之前,内容必须通过三道关口:匹配情境,才会被检索到;匹配人设,才会被选用给对的人;带有品牌专属证据,才会被推荐,而不只是被列出。新加坡管理大学 MAF 研究正是这篇论文的案例。
本案例的局限
- 衡量的是可见度,不是招生结果。这里测量的是四个 AI 模型针对一组固定问题给出的回答。申请、咨询和入学数据由大学在自己的系统中追踪。
- 只有七天。足以看到清晰的效果,但不足以断定趋势。内容不持续维护,引用就会衰减。
- 仅限中文模型。ChatGPT、Claude 和 Gemini 读取的来源不同,需要单独检测。
- 答案会波动。同一个模型每次给出的答案措辞都不一样。重复采样能把这种波动控制在已知范围内,但无法消除它。
关于本案例的常见问题
研究期间,新加坡管理大学的官网有改动吗?
没有。十篇文章全部发布在第三方中文内容平台上——今日头条、抖音、搜狐、哔哩哔哩和知乎。官网保持原样,因此变化不可能来自官网。
哪些 AI 模型引用了这些文章?
十篇文章中有五篇被引为来源:豆包引用了四篇(两篇在今日头条,两篇在搜狐),DeepSeek 引用了一篇(在知乎)。可见度测量覆盖豆包、DeepSeek、通义千问和腾讯元宝。
其他人设也受益了吗?
在其他四类人设的问题下,我们的文章都没有被引用。每类人设都需要专门为它撰写的内容。
这套方法经过同行评审了吗?
是的。这项研究已撰写成论文《Persona-Driven AI Engine Optimization in Zero-Click Search》,经同行评审,获 ANZMAC 2026 接收并受邀作口头报告。
想为你的品牌做同样的测量?第一步是基线测量:你的人设、他们会问的问题,以及 AI 今天把你放在哪里。