要排在别人前面,靠的是只有你才写得出的证据。
AI 可见度得分,2026 年 1 月 28 日–2 月 4 日。一个金融硕士项目,四个中文模型。 阅读案例- B
- 行为
- P
- 这个人
- E
- 他所处的情境
成为 AI
推荐的品牌。
买家选择什么,取决于他是谁,以及他正处在怎样的时刻。我们为这两者建模,在十个 AI 模型上提出他们真实会问的问题,让你清楚看到自己的位置。Jeffery Asia 出品的 AI SEO、GEO 与 AEO 方案。
error
请输入域名,例如 yourbrand.com。
arrow_upward
请输入你的品牌官网,开始免费诊断。
搜索给每个人
同样的十条链接。
AI 给每个人
不一样的答案。
不再有“第一页”可争。只有买家得到的那个答案——以及答案里有没有你。
为什么这不是 SEO
AI 早已知道是谁在问。
每个 AI 助手都会根据用户过往的提问,为他勾勒一幅画像——他的处境、他的限制、他反复回到的问题。然后,它回答的是这个人。
所以,同一个问题并没有唯一的答案可供优化。有多少类买家,就有多少种答案。
我们优化的,是这个
B = f(P, E)
四个字母,一个道理:买家做什么,取决于他是谁,以及他身边正在发生什么。把这两点都摸准,你就能在他动手输入之前,写出他要问的问题。
Lewin,1951 年。我们把它用在 AI 搜索上。
亲手试一试
换一个提问的人。
换一个提问的人。
换一种处境。
看推荐如何随之改变。
P
E
B · 他实际输入的问题
“我一个月前开始跑步,每次跑完膝盖都疼——需要换双鞋吗?换哪款?”
答案点名了谁
- 1某竞品品牌
- 2你
- 3某测评网站
涉及伤痛的问题,更青睐用大白话讲清缓震的品牌。你的选鞋适配指南恰好做到了——所以答案点了你的名。
示意:以一个跑鞋品牌为例。在真实检测中,人设和他们的问题都来自你自己提供的资料——绝不凭空编造。
没人算进预算的一环
你的买家会用三十种方式问 AI。
你的买家会用三十种方式问 AI。
有几个答案点了你的名?
五类买家,每类两种情境,每种情境三个问题。这三十个问题,AI 逐一单独作答——所以一个品牌可能拿下其中一个,却在其余二十九个里毫无踪影。
大多数品牌从没数过。数过的品牌,不再靠猜来决定营销预算投向哪里。
AI 点名你AI 点名别人
7/ 30 个问题点了你的名
坦白说
三件事决定答案。
三件事决定答案。
我们能撬动的,是其中一件。
我们左右不了用户的账号历史
AI 助手早已为这位用户建立的画像。
这正是我们的工作它作答时读到的内容
它在那一刻主动检索、并决定采信的来源。
我们左右不了模型本身
同一个问题问两次,答案读起来不会一模一样。这种波动很正常,落在我们预期并测量的误差范围之内。
然后,为返回的答案打分
同样的问题,同样的模型,每天一次。
MR提及率我们到底有没有被提到?
OF出现频率一笔带过,还是贯穿全文?
AR排名排在榜首,还是第九?
BCR内容占比答案里有多少在讲我们?
某一天的一个分数只是天气,不是气候。我们报告的是趋势——哪个月没有起色,我们也会如实说。
看看 AI 如何回答你的客户
对比你的品牌在这 10 个 AI 模型与答案平台上的存在感。每份报告都会列明测试了哪些模型、哪些问题。
腾讯元宝、小红书和 Google AI 概览不在自动检测范围内,我们的团队可以为这些平台补充可见度评分。联系我们添加
滑动查看全部 10 个模型 ChatGPT
 Claude
 Gemini
 DeepSeek
 通义千问
 豆包
 Kimi
 腾讯混元
 Grok
 Perplexity
做那个答案,
而不是第十条链接。
这项工作要改变的三件事。每一件都是一个数字,用同一方法前后测量两次。
国际轨83.0
中文轨32.6
你的一半买家在问 ChatGPT,另一半在问豆包、DeepSeek 或小红书——它们读的是一个完全不同的互联网。
两条轨道如何分别计分某内容平台
某新闻门户
某教育网站
你自己的官网0
在一次客户诊断中,中文模型引用品牌自有域名的次数为零。内容本身没问题,只是放错了地方。
内容究竟该放在哪里
查看你自己的三个数字
建立基线只需一次检测。哪怕只做到这一步,也值得。
我们的服务周期
六个步骤,从第一通电话起由同一位客户经理全程负责。第六步开启下一个周期。
- 第 1 周01
需求访谈
客户经理了解你想赢得的受众,并收集品牌与业务资料——经你授权后共享,必要时做匿名化处理。
需求简报与数据接入 - 第 1–2 周02
核心受众与首次诊断
我们构建你的核心买家人设及其购买情境,然后进行首次诊断,得出可见度基线得分。
人设 · 基线得分 - 第 2 周03
项目启动
我们与你共同确定优先优化哪些受众和业务线,以及怎样才算成功。
共同确认的目标与 KPI - 每月04
优化
针对每个目标人设和情境撰写内容,并发布到模型真正会读取的平台上。
文章上线于 AI 会读的平台 - 每天05
追踪与测量
同样的问题,每天重新检测。得分、引用与竞品情况,用通俗的语言报告给你。
报告 · 首份 30 天内交付 - 每个周期06
复盘与重新诊断
哪些指标变了、为什么变。用新的市场信号更新人设,下一个周期以一次全新诊断开启。
复盘 · 下一周期计划
真实项目,具体证据。
三样东西值得细看:做过的项目、合作的人,以及背后的研究。
帮助金融申请人在 AI 答案中找到新加坡管理大学(SMU)
我们先测出新加坡管理大学的现状:AI 已经在哪些申请人人设和情境下推荐它,又在哪些地方让它消失。然后,我们制定了一套写给 AI 读的内容策略。
针对新加坡管理大学的应用金融硕士(MAF)项目,JefurryAxis 梳理了申请人的需求,围绕他们面临的决策生成定制文章,并将文章发布到 AI 模型会检索的内容平台上。
69.177.2
AI 可见度得分 · 2026 年 1 月 28 日–2 月 4 日
我们的 10 篇文章中有 5 篇被引为来源——豆包引用 4 篇,DeepSeek 引用 1 篇——而且只出现在目标人设的提问之下。
数据由 Jeffery Asia 针对本案例的申请人画像,在通义千问、豆包、DeepSeek 和腾讯元宝上测得并报告。这是可见度结果,不代表招生人数或营收。
阅读完整案例研究 → · 在 jeffery.asia 查看 ↗新加坡国立大学 EMBA
是 AI 搜索领域的合作伙伴,而不只是客户。新加坡国立大学 EMBA 与我们的团队从早期就携手投入 AEO、GEO 与 AI SEO——用真实的申请人问题检验方法,并肩解读结果,不断打磨高管教育决策的测量方式。
高管教育 · 长期的 AEO 与 GEO 研究合作。
在 jeffery.asia 阅读案例 ↗研究成果获 ANZMAC 2026 接收
《Persona-Driven AI Engine Optimization in Zero-Click Search》经同行评审,获接收并受邀作口头报告。致 Dr. Jia Yun 的邀请函已对此予以确认。
获接收并受邀作口头报告 · 会议将于 2026 年 11 月 30 日–12 月 2 日在奥克兰举行。
论文背后的研究 → · ANZMAC 2026 会议官网 ↗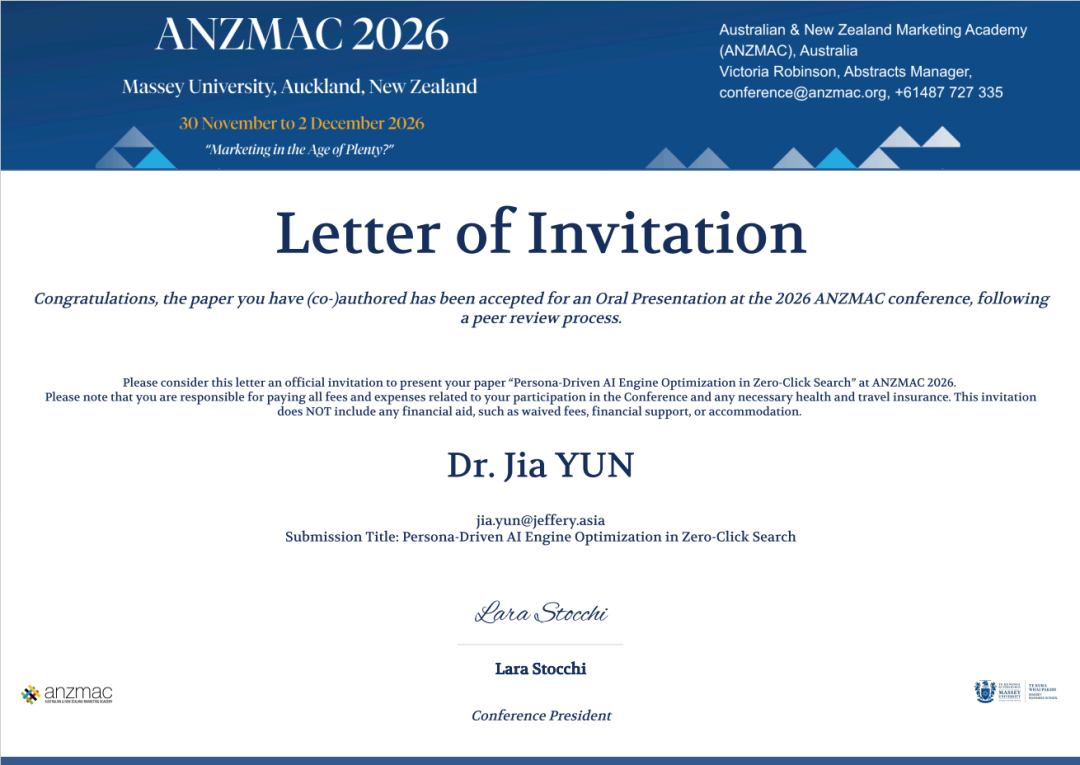
由 Jeffery Asia 打造
JefurryAxis 是 Jeffery Asia 旗下的 AI 可见度产品。Jeffery Asia 是一家新加坡增长服务机构,自 2016 年起深耕教育、医疗、金融与跨境服务领域。JefurryAxis 背后的研究、测量方法和交付团队,都来自这里。
团队成员来自新加坡国立大学、南洋理工大学、麻省理工学院和墨尔本大学——拥有深厚的品牌研究经验,长期扎根中华与东南亚文化,每一个项目背后都有扎实的学术与技术研究支撑。
合作机构
覆盖教育、金融、政府与跨境服务


常见问题
常见问题
一句话说清 B = f(P, E) 是什么?
一个人做什么,取决于他是谁、身处什么情境。我们用它预测你的买家会向 AI 提出哪些问题——再检查答案里有没有你。方程出自 Lewin(1951 年);把它用于 AI 搜索,是我们的做法。
这和 SEO 有什么不同?
SEO 帮你在结果页上拿到一条链接。而这里要做的,是成为答案里的那个推荐——那里根本没有“第一页”可供你排在第七。
你们怎么测量?
用不含品牌词的问题,在三个国际模型和三个中文模型上提问,每个问题都问不止一次。我们为四件事打分:有没有点名你、出现多少次、排得多靠前、答案里有多少在讲你;之后周期性地再问完全相同的问题。
你们覆盖哪些平台?
ChatGPT、Claude、Gemini、Perplexity、Grok、DeepSeek、通义千问、豆包、Kimi、腾讯混元。腾讯元宝、小红书“问一问”和 Google AI 概览由团队辅助检测。哪些平台重要,取决于你的买家在哪里提问。
你们能保证我们被推荐吗?
不能,谁都不能。我们能做的,是针对你最想赢得的那几类人设做优化——这套方法经过了检验。我们经同行评审的研究《Persona-Driven AI Engine Optimization in Zero-Click Search》发现:为某一人设撰写的文章,只在该人设的提问下被引用,而品牌的 AI 可见度得分从 69.1 升至 77.2——定向是成立的。在我们的小红书案例中,同一方法让品牌实现了从 0 到 1:此前答案里没有它,优化后被推荐、被引用。
JefurryAxis 和 Jeffery Asia 是什么关系?
JefurryAxis 是新加坡增长服务机构 Jeffery Asia 打造的 AI 可见度产品。研究、方法与交付团队都来自那里。
首次合作是什么样的?
先建基线,再谈方案——看清你所处的位置、正在流失哪些买家,以及模型依据哪些来源做出判断。哪怕只做到这一步,也值得。
成为 AI
推荐的品牌
每一天,你所在市场里的人都在问 AI 该信哪个品牌,而 AI 会给出一个名字。我们帮你确保那个名字是你——从看清你今天的位置开始。